MariaDB 10.11 덤프·복원 검증 — customers 테이블로 원본과 대상 비교하기
덤프 파일이 만들어졌다는 사실만으로 복원이 제대로 끝났다고 판단할 수는 없다. 이 글은 기존 실습 이미지의 testdb와 testdb_target을 기준으로, customers의 행 수와 ID 집계를 비교하고 테이블 통계와 부가 객체 수를 확인하는 과정을 정리한다.
이미지에 기록된 결과는 별도 스키마로 복원한 실습 범위다. 새 운영 서버로 트래픽을 전환하거나 애플리케이션까지 검증했다는 의미는 아니다. 아래에서는 이미지에서 확인되는 결과와 추가로 필요한 검사를 구분한다.
1. 비교 대상과 실습 범위
- 글의 대상 버전: MariaDB 10.11. 정확한 패치 버전과 클라이언트 버전은 실행 전에 별도로 확인한다.
- 명령 실행 환경: 이미지의 Windows PowerShell과 MariaDB 클라이언트.
- 원본 스키마:
testdb, 복원 대상:testdb_target. - 핵심 비교 테이블:
customers, 집계 컬럼:customer_id. - 이미지에 표시된 기본 테이블: 9개. 부가 객체 비교 결과는 뷰 3개, 루틴·트리거·이벤트 각각 0개다.
두 스키마를 한 SQL에서 비교하려면 같은 MariaDB 인스턴스에서 접근할 수 있어야 한다. 실제로 서로 다른 서버를 비교할 때는 각 서버에서 같은 집계 쿼리를 실행하고 결과를 대조한다. 비교 중 데이터가 바뀌면 차이의 원인을 구분하기 어려우므로 실습에서는 쓰기를 멈춘 상태를 전제로 한다.
SELECT VERSION();
SHOW CREATE DATABASE testdb;
SHOW CREATE TABLE testdb.customers;
2. 덤프 파일을 만들고 산출물을 기록한다
이미지에서는 migration.cnf의 source·target 접속 그룹을 사용한다. 실제 자격 증명은 이 파일에 두고 작업 계정만 읽을 수 있도록 제한한다. 아래 명령은 해당 설정 파일과 필요한 권한이 준비된 환경에서 실행하는 예시다.
$dumpStarted = Get-Date
mariadb-dump --defaults-extra-file=./migration.cnf --defaults-group-suffix=-source --single-transaction --quick --routines --events --triggers --default-character-set=utf8mb4 --no-create-db testdb --result-file=testdb-migration.sql
if ($LASTEXITCODE -ne 0) { throw '덤프 실패: 오류 출력을 확인하세요.' }
(Get-Date) - $dumpStarted
Get-Item .\testdb-migration.sql | Select-Object Name, Length, LastWriteTime
Get-FileHash .\testdb-migration.sql -Algorithm SHA256
원본 이름과 다른 스키마로 복원하므로 이 예시에서는 --databases testdb를 사용하지 않는다. 복원 전에 덤프의 USE문과 스키마가 명시된 객체 정의도 확인해야 한다. 특히 뷰가 원본 스키마를 참조하면 대상에 뷰가 생성돼도 원본 데이터를 읽을 수 있다.
--single-transaction을 사용하더라도 비트랜잭션 테이블이나 덤프 중 DDL까지 같은 방식으로 보호되는 것은 아니다. 사전에 엔진과 변경 작업을 확인한다.
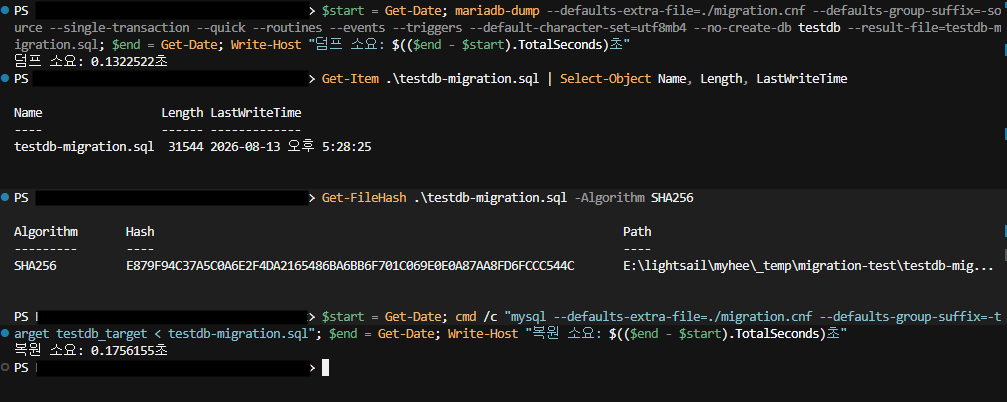
파일 해시는 전송 전후 산출물이 같은지 확인하는 데 사용한다. 파일 해시가 같다는 사실은 복원된 DB의 데이터가 원본과 같다는 증거가 아니다.
3. 비어 있는 대상 스키마에 복원한다
testdb_target은 원본의 문자셋·collation에 맞춰 별도로 준비하고, 기존 서비스가 사용하는 DB가 아닌지 확인한다. 이미 데이터가 있는 대상에 덤프를 바로 실행하지 않는다. 덤프에는 기존 객체를 바꾸거나 삭제하는 SQL이 포함될 수 있다.
다음은 이미지와 같은 Windows 환경의 복원 명령이다. PowerShell에서 입력 리디렉션을 처리하도록 cmd /c를 사용한다. 이미지의 mysql은 당시 MariaDB 클라이언트 명칭이며, 재실행 시에는 덤프 형식과 호환되는 클라이언트 버전을 확인한다.
$restoreStarted = Get-Date
cmd /c "mysql --defaults-extra-file=./migration.cnf --defaults-group-suffix=-target testdb_target < testdb-migration.sql"
if ($LASTEXITCODE -ne 0) { throw '복원 실패: 부분 복원 상태와 오류를 확인하세요.' }
(Get-Date) - $restoreStarted
실패했다면 같은 덤프를 무조건 다시 실행하지 않는다. 오류와 부분 복원 상태를 확인한 뒤, 격리된 대상의 재준비 여부를 결정한다.
4. customers의 정확한 행 수와 ID 집계를 비교한다
SELECT 'SOURCE' AS db,
       COUNT(*) AS row_count,
       MIN(customer_id) AS min_id,
       MAX(customer_id) AS max_id,
       COALESCE(SUM(customer_id), 0) AS id_sum
FROM testdb.customers
UNION ALL
SELECT 'TARGET', COUNT(*), MIN(customer_id), MAX(customer_id),
       COALESCE(SUM(customer_id), 0)
FROM testdb_target.customers;
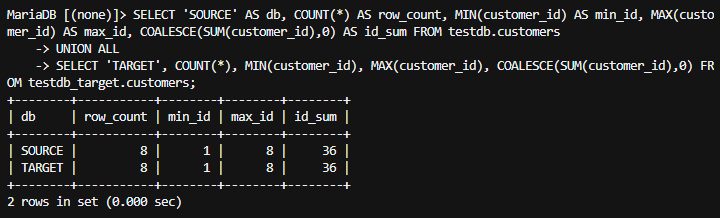
이 결과로 확인되는 것은 행 수와 세 가지 ID 집계의 일치다. 고객명 등 다른 컬럼의 값이나 전체 데이터의 동일성까지 입증하지는 않는다. 추가 검증에서는 실제 스키마의 비교 대상 컬럼을 정하고 기본 키별 값을 대조해야 한다. 고객 데이터가 포함된 결과는 공개 전에 익명화한다.
5. 9개 테이블의 통계값을 비교한다
SELECT s.TABLE_NAME,
       s.TABLE_ROWS AS src_rows,
       t.TABLE_ROWS AS tgt_rows,
       IF(s.TABLE_ROWS = t.TABLE_ROWS, 'OK', 'MISMATCH') AS result
FROM information_schema.TABLES s
JOIN information_schema.TABLES t ON s.TABLE_NAME = t.TABLE_NAME
WHERE s.TABLE_SCHEMA = 'testdb'
  AND t.TABLE_SCHEMA = 'testdb_target'
  AND s.TABLE_TYPE = 'BASE TABLE'
  AND t.TABLE_TYPE = 'BASE TABLE'
ORDER BY s.TABLE_NAME;
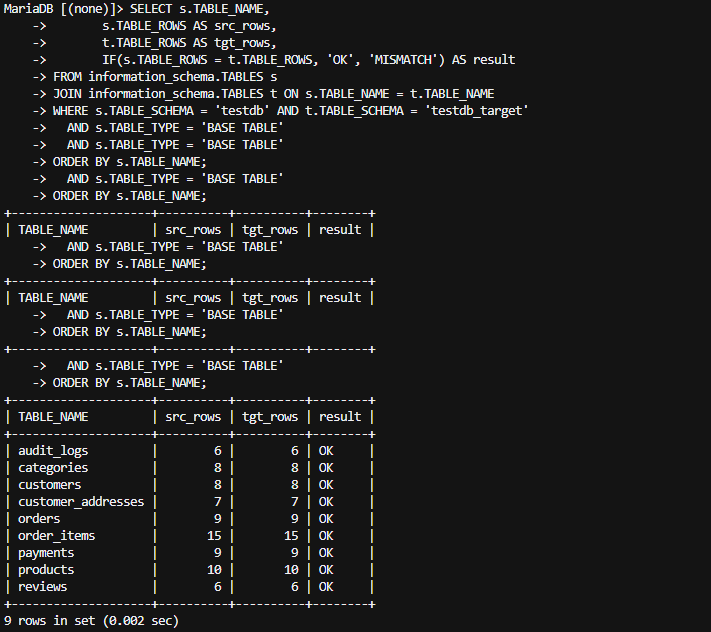
InnoDB의 TABLE_ROWS는 추정치일 수 있으므로 이 화면을 “전체 테이블의 정확한 행 수 검증 완료”로 해석하면 안 된다. 또 INNER JOIN은 한쪽에만 있는 테이블을 제외한다. 다음 추가 검사로 누락 객체를 확인하고, 정확한 행 수가 필요한 테이블에는 COUNT(*)를 실행한다. 아래 추가 검사의 결과는 기존 이미지에 포함돼 있지 않다.
SELECT TABLE_NAME, TABLE_TYPE,
       SUM(TABLE_SCHEMA = 'testdb') AS source_present,
       SUM(TABLE_SCHEMA = 'testdb_target') AS target_present
FROM information_schema.TABLES
WHERE TABLE_SCHEMA IN ('testdb', 'testdb_target')
GROUP BY TABLE_NAME, TABLE_TYPE
HAVING source_present <> target_present;
6. 뷰와 루틴·트리거·이벤트 개수를 확인한다
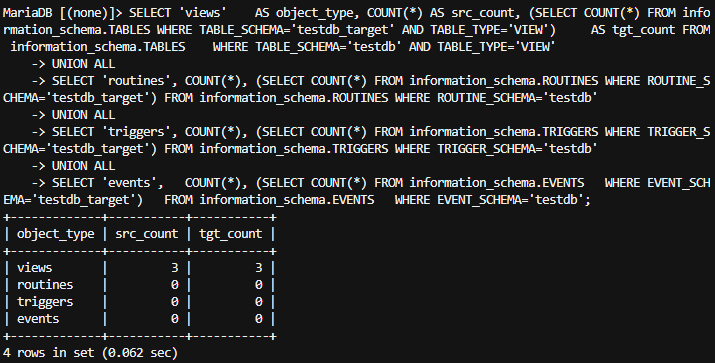
개수가 같아도 객체 이름과 정의가 같다는 뜻은 아니다. 다음 단계에서는 뷰 이름을 대조하고 각 뷰의 SHOW CREATE VIEW 결과에서 참조 스키마와 DEFINER를 확인한다. 특히 testdb_target의 뷰가 의도치 않게 testdb를 참조하지 않는지 확인해야 한다. 이미지에는 뷰 정의와 조회 결과까지 제시돼 있지 않으므로 이 검사가 끝났다고 단정하지 않는다.
SELECT TABLE_SCHEMA, TABLE_NAME, DEFINER, SECURITY_TYPE
FROM information_schema.VIEWS
WHERE TABLE_SCHEMA IN ('testdb', 'testdb_target')
ORDER BY TABLE_NAME, TABLE_SCHEMA;
7. 이 실습에서 확인한 것과 서버 이전 전 남은 검사
이미지에서 확인되는 결과는 덤프 산출물과 실행 시간, customers의 행 수·ID 집계 일치, 9개 기본 테이블의 통계값 일치, 부가 객체 수 일치다. customers 이외의 정확한 행 수, 전체 컬럼 값, 뷰 정의와 애플리케이션 동작까지 검증한 자료는 아니다.
실제 서버 이전에서는 추가로 문자셋·한글·이모지, 인덱스·제약조건·AUTO_INCREMENT, 계정 권한, 애플리케이션 조회·쓰기와 백그라운드 작업을 점검한다. 트래픽 전환 전에는 쓰기 중단과 최종 동기화 방법, 전환 후에는 오류율과 연결 상태를 확인할 기준을 정한다. 대상에 새 데이터가 쌓인 뒤에는 연결만 원본으로 바꿔도 복구되는 것이 아니므로 롤백 시 데이터 처리 방법도 미리 결정해야 한다.
참고 자료
문서 확인일: 2026-09-08. 이미지의 기존 실습 결과를 바탕으로 설명을 정리했으며, 이번 편집에서 DB 명령을 새로 실행한 것은 아니다.
댓글 0